
| fiologparser_hist.py(1) | General Commands Manual | fiologparser_hist.py(1) |
نام (NAME)
fiologparser_hist.py - محاسبه آمارهای حاصل از هیستوگرامهای fio
خلاصه دستور (SYNOPSIS)
fiologparser_hist.py [گزینهها] [clat_hist_files]...
توضیحات (DESCRIPTION)
fiologparser_hist.py ابزاری برای تبدیل فایلهای *_clat_hist* تولیدشده توسط fio به یک فایل CSV از آمارهای تاخیر شامل کمینه، میانگین، بیشینه تاخیر و صدکهای قابل انتخاب است.
مثالها (EXAMPLES)
$ fiologparser_hist.py *_clat_hist*
end-time, samples, min, avg, median, 90%, 95%, 99%, max
1000, 15, 192, 1678.107, 1788.859, 1856.076, 1880.040, 1899.208, 1888.000
2000, 43, 152, 1642.368, 1714.099, 1816.659, 1845.552, 1888.131, 1888.000
4000, 39, 1152, 1546.962, 1545.785, 1627.192, 1640.019, 1691.204, 1744
...
گزینهها (OPTIONS)
- --help
- چاپ این گزینهها.
- --buff_size=int
- تعداد نمونههایی که در هر بار در numpy بافر میشوند. پیشفرض ۱۰,۰۰۰ است. این مقدار را میتوان برای بهبود کارایی تنظیم کرد.
- --max_latency=int
- مدتزمان دادهها بر حسب ثانیه برای پردازش در هر نوبت. مقدار پیشفرض ۲۰ ثانیه است، تا حد بالای ۱۷ ثانیهای تاخیر در هیستوگرامهای گزارششده توسط fio پوشش داده شود. اگر fio با بیشینه تاخیر بزرگتری اجرا شده باشد، این مقدار باید افزایش یابد. کاهش این مقدار در صورتی که بیشینه تاخیر کمتری مشخص باشد، میتواند کارایی را بهبود بخشد. برای جزئیات بیشتر به بخش «نکات» مراجعه کنید.
- -i, --interval=int
- بازه زمانی گزارش آمارها. مقدار پیشفرض ۱۰۰۰ میلیثانیه است. این مقدار باید حداقل برابر با مقدار ارائهشده برای log_hist_msec به fio تنظیم شود.
- --noweight
- عدم وزندهی نمونهها بین بازههای خروجی. پیشفرض False است.
- -d, --divisor=int
- تقسیم آمارها بر این مقدار. پیشفرض ۱ است. زمانی کاربرد دارد که بخواهید تاخیرها را از میلیثانیه به ثانیه تبدیل کنید (divisor=1000).
- --warn
- فعالسازی نمایش پیامهای هشدار در stderr، کاربردی برای اشکالزدایی.
- --group_nr=int
- اگر fio دوباره کامپایل شده باشد، این مقدار را برابر با مقدار FIO_IO_U_PLAT_GROUP_NR تعریفشده در stat.h قرار دهید. پیشفرض ۱۹ است که مقدار فعلی مورد استفاده در fio میباشد. برای جزئیات بیشتر به بخش «نکات» مراجعه کنید.
- --percentiles=str
- ارسال فهرست صدکهای مورد نظر برای چاپ، جداشده با کاما یا دونقطه. مقدار پیشفرض "90.0:95.0:99.0" است، اما صدکهای کمینه، میانه (۵۰٪) و بیشینه همیشه چاپ میشوند.
- --usbin
- برای اعلام به تحلیلگر مبنی بر اینکه مقادیر تاخیر سطلهای هیستوگرام بر حسب میکروثانیه هستند. پیشفرض استفاده از نانوثانیه است، اما لاگهای هیستوگرام در نسخههای fio کمتر یا مساوی ۲.۹۹ بر حسب میکروثانیه هستند.
- --directions=str
- به طور پیشفرض، سطلهای هیستوگرام تمام جهات (مانند خواندن و نوشتن) با یکدیگر ترکیب شده و یک نتیجه «مخلوط» (mixed) ایجاد میکنند. برای تولید نتایج مستقل بر اساس جهت، ترکیبی از نویسههای ´rwtm´ را با گزینه --directions=rwtm ارسال کنید. ستونی به نام ´dir´ اضافه میشود که جهت نتیجه را برای هر سطر نشان میدهد.
نکات (NOTES)
زمانهای پایان بهصورت گامهای یکنواخت از مقدار ارائهشده برای --interval محاسبه میشوند، بدون در نظر گرفتن اینکه نمونههای هیستوگرام چه زمانی گزارش شدهاند. نکات قابل توجه:
بازههایی با یک نمونه واحد، مقداری یکسان برای تمامی آمارها خواهند داشت.
تعداد نمونهها بدون وزن است و متناظر با تعداد کل نمونههایی است که هرگونه تاثیری بر بازه داشتهاند.
آمارهای کمینه با استفاده از مقدار مرز پایینی نخستین سطل (به ترتیب افزایشی سطلها) که دارای نمونههای غیرصفر است محاسبه میشوند. به طور مشابه برای بیشینه، مرز بالایی آخرین سطل با نمونههای غیرصفر در نظر گرفته میشود. از نظر معنایی، این کار همارز با در نظر گرفتن صدکهای ۰ و ۱۰۰ با بافر ۵۰٪ پهنای سطل است (چرا که صدکها با استفاده از نقاط میانی سطلها محاسبه میشوند). این امر ویژگیهای مطلوب زیر را اعمال میکند:
مقادیر کمینه و بیشینه کرانهای پایین و بالای اکید برای کمینه / بیشینه واقعی دیدهشده توسط fio هستند (و در *_clat.* با غیرفعال بودن میانگینگیری گزارش میشوند).
آمارهای میانگین از میانگین حسابی وزندار استاندارد استفاده میکنند.
هنگامی که گزینه --noweights مقدار false باشد (پیشفرض)، آمارهای صدک با استفاده از روش صدک وزندار به گونهای که در پیوند زیر شرح داده شده محاسبه میشوند: https://en.wikipedia.org/wiki/Percentile#Weighted_percentile برای جزئیات بیشتر درباره نحوه محاسبه وزنها برای نمونههای منفرد به متد weights() مراجعه کنید. در process_interval() ما وزنها را بیشتر در ارتفاع هر سطل ضرب میکنیم تا هیستوگرامهای وزندار بهدست آیند.
فایلهای ارائهشده در خط فرمان که فرض میشود فایلهای هیستوگرام fio هستند تبدیل میشوند. یک فایل هیستوگرام منفرد میتواند شامل هیستوگرامهایی برای چندین جهت مختلف خواندن/نوشتن باشد (به ویژه زمانی که --rw=randrw باشد). این موضوع با ردیابی جداگانه هر جهت خواندن/نوشتن مدیریت میشود. در آمارهای گزارششده، ما در نهایت *تمام* هیستوگرامها را (بدون در نظر گرفتن جهت خواندن/نوشتن) ادغام میکنیم.
مقدار *_GROUP_NR در stat.h (و *_BITS) تعیین میکند که هنگام فعال بودن هیستوگرام، fio چه تعداد سطل تاخیر تولید کند. به طور مشخص برای مقدار پیشفرض فعلی GROUP_NR=19، ما ۱٬۲۱۶ سطل با بیشینه تاخیر تقریبی ۱۷ ثانیه خواهیم داشت. برای برخی کاربردها این مقدار ممکن است کافی نباشد. با GROUP_NR=24 ما ۱٬۵۳۶ سطل داریم که به ما بیشینه تاخیر ۵۴۱ ثانیه (حدود ۹ دقیقه) را میدهد. اگر انتظار دارید برنامه شما تاخیرهای بیش از ۱۷ ثانیه را تجربه کند، باید fio را با مقدار GROUP_NR بزرگتری بازکامپایل کنید، به عنوان مثال با:
sed -i.bak 's/^#define FIO_IO_U_PLAT_GROUP_NR 190#define FIO_IO_U_PLAT_GROUP_NR 24/g' stat.h
make fio
جدول مرجع سریع برای بیشینه تاخیر متناظر با نمونهای از مقادیر GROUP_NR:
GROUP_NR | # bins | max latency bin value
19       | 1216   | 16.9 sec
20       | 1280   | 33.8 sec
21       | 1344   | 67.6 sec
22       | 1408   | 2  min, 15 sec
23       | 1472   | 4  min, 32 sec
24       | 1536   | 9  min, 4  sec
25       | 1600   | 18 min, 8  sec
26       | 1664   | 36 min, 16 sec
در حال حاضر این برنامه به طور خودکار تعداد سطلهای هیستوگرام در فایلهای لاگ را تشخیص داده و مقادیر تاخیر سطلها را بر همان اساس تنظیم میکند. به ویژه اگر از پارامتر --log_hist_coarseness در fio استفاده کنید، فایلهای خروجی با تعداد سطلی مطابق جدول زیر دریافت میکنید (توجه داشته باشید که سطر اول با جدول بالا یکسان است):
coarse \ GROUP_NR
        19     20    21     22     23     24     25     26
   -------------------------------------------------------
  0  [[ 1216,  1280,  1344,  1408,  1472,  1536,  1600,  1664],
  1   [  608,   640,   672,   704,   736,   768,   800,   832],
  2   [  304,   320,   336,   352,   368,   384,   400,   416],
  3   [  152,   160,   168,   176,   184,   192,   200,   208],
  4   [   76,    80,    84,    88,    92,    96,   100,   104],
  5   [   38,    40,    42,    44,    46,    48,    50,    52],
  6   [   19,    20,    21,    22,    23,    24,    25,    26],
  7   [  N/A,    10,   N/A,    11,   N/A,    12,   N/A,    13],
  8   [  N/A,     5,   N/A,   N/A,   N/A,     6,   N/A,   N/A]]
برای سایر مقادیر GROUP_NR و درشتدانگی (coarseness)، این جدول را میتوان به این صورت محاسبه کرد:
bins = [1216,1280,1344,1408,1472,1536,1600,1664]
max_coarse = 8
fncn = lambda z: list(map(lambda x: z/2**x if z % 2**x == 0 else nan, range(max_coarse + 1)))
np.transpose(list(map(fncn, bins)))
اگر GROUP_NR را برای کاربرد (با تاخیر بالای) خود تنظیم نکرده باشید، صدکهای محاسبهشده توسط این ابزار در بیشینه مقدار سطل تاخیر مطابق جدول اول بالا و این نمودار به سقف خود میرسند (جایی که GROUP_NR=19 است و بنابراین بیشینه تاخیر حدود ۱۶.۷ ثانیه را در خط قرمز مشاهده میکنیم):
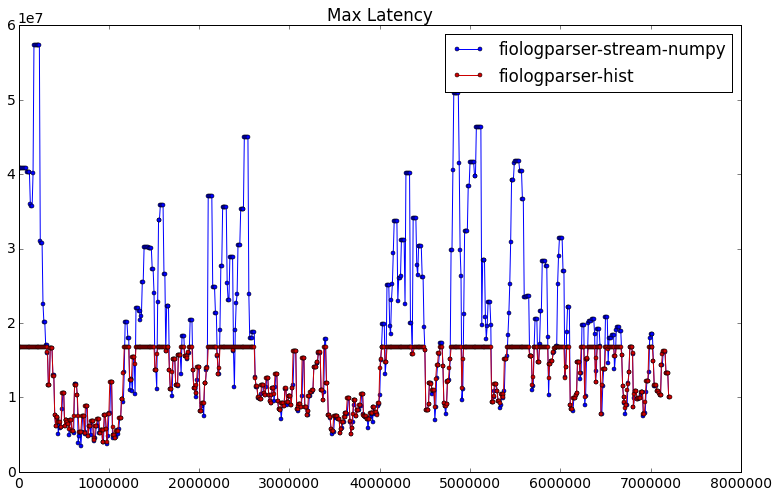
انگیزه، تصمیمات طراحی و فرایند پیادهسازی با جزئیات بیشتر در پیوند زیر شرح داده شدهاند:
نویسنده (AUTHOR)
fiologparser_hist.py و این صفحه راهنما توسط Karl Cronburg <karl.cronburg@gmail.com> نوشته شدهاند.
گزارش باگها (REPORTING BUGS)
گزارش باگها به فهرست پستی fio به آدرس <fio@vger.kernel.org> ارسال شود.
| August 18, 2016 |